deepinfer开源官方地址入口 deepinfer开源链接github
DeepInfer是DeepSeek开源的生产级大模型离线推理框架,是DeepSeek线上服务跑V4.1-Flash的同款底层推理引擎,不是通用推理框架,优先为DeepSeek-V4.1-Flash(MoE)深度定制。
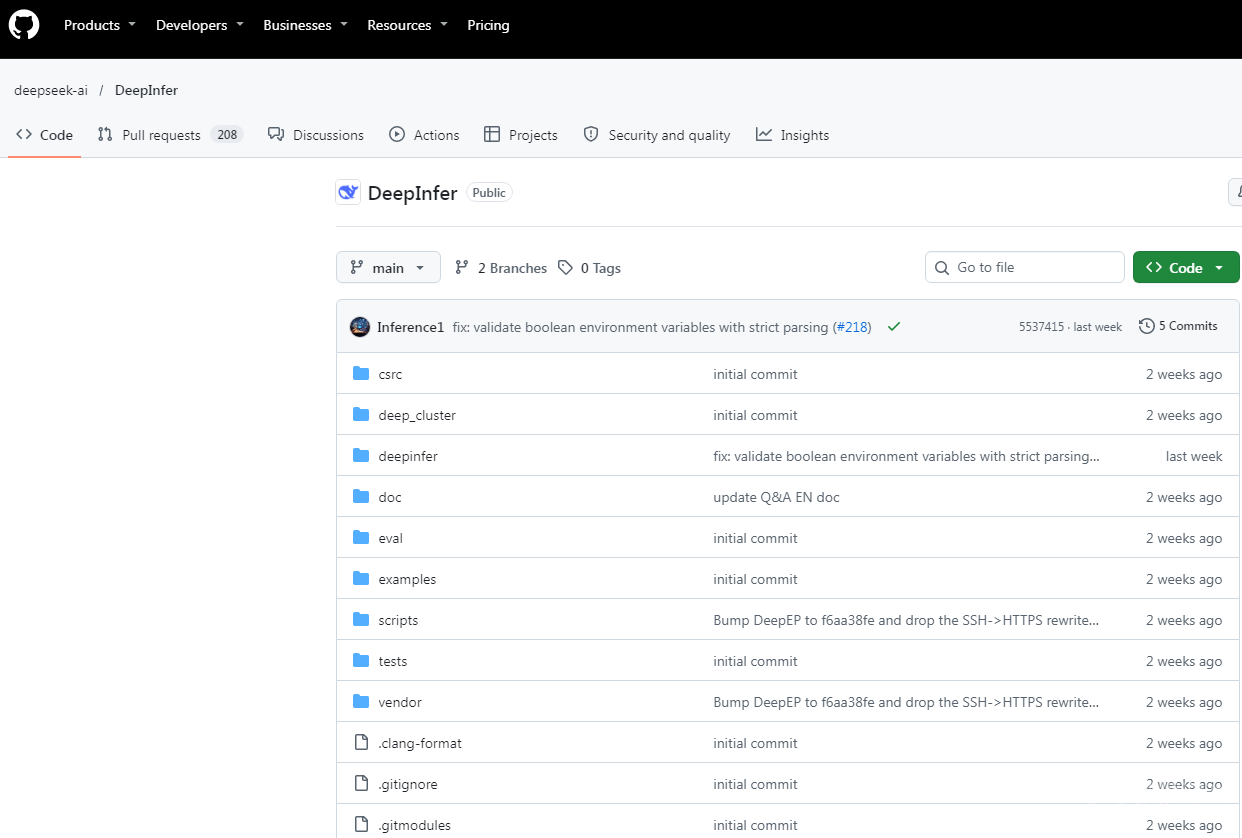
deepinfer开源官方地址入口:https://github.com/deepseek-ai/DeepInfer
deepinfer功能特色
1、自研高性能算子栈:内置FlashMLA、DeepGEMM、DeepEP、TileLang自定义算子,专门优化MoE注意力、矩阵计算、专家通信,MoE场景下算子开销更低。
2、MoE分布式并行+ EPLB专家负载均衡:支持DP(数据并行)、CP(上下文并行)、EP(专家并行);EPLB做专家负载均衡,避免部分专家热点、部分专家空闲,MoE集群瓶颈优化是重点。
3、DSpark置信度调度投机解码(核心亮点):和普通固定长度投机解码不同:草稿token生成后,用置信度预测动态决定验证多少个token,低置信就少校验、提前回退;官方说相比固定校验吞吐提升4%–7%。
4、零开销异步批量调度、Batch-invariant批不变推理:异步调度器流水线overlap,请求批处理不干扰单请求解码行为;批不变推理保证:不管是单请求还是混批,采样结果确定性一致,适合业务对结果稳定有要求的场景。
5、SWA有界重放+确定性采样:支持稳定权重重放、可复现采样结果,方便对齐线上效果、做回归测试;原生支持结构化输出(xgrammar),输出JSON等格式不容易乱码、逃逸。
6、双后端:NVIDIA +昇腾同一套引擎同时适配英伟达新架构和昇腾950,国产算力友好。
⚠️ 重要边界:开源版本是离线推理核心,不带开箱即用OpenAI API、多租户网关、KV Cache分离部署组件,拿到代码需要自己封装服务层。
deepinfer有什么用
1、私有化部署DeepSeek-V4.1-Flash
想本地/私有集群跑V4.1-Flash MoE、追求高吞吐、对齐DeepSeek官方原生推理行为,优先选它,比改通用框架适配更省心。
2、大规模离线批量任务
大批量推理:文档批量摘要、批量代码生成、批量数据打标、Agent批量跑任务,主打高token吞吐,官方集群指标:单集群日吞吐155万亿token(厂商宣传值)。
3、MoE大模型系统学习与二次开发
学习工业级MoE推理、专家并行、投机解码、负载均衡的工程实现;研究人员可以基于它魔改调度策略、算子、投机算法。
4、自建AI业务降本
算力充足的企业,用来搭建自研推理集群,提升GPU利用率、降低单token推理成本;搭配deepseek-recipe,可以对齐DeepSeek API协议,上层应用几乎不用改代码切换服务端。